
主题
面试速答(先看这里)
**一句话结论:**因为用户只查询最近30天的数据,所以,可以简单的按照时间来划分冷热数据,30天内的数据为热数据,30天以外的数据为冷数据。
60秒标准回答:
分析一下题干的几个关键信息
1、一天一千万数据
2、只查最近30天的数据
**答题顺序:**结论 → 原理/机制 → 关键流程 → 场景与取舍 → 易错点
回答主线:
- **要点1:**1天就1000万数据,一年就30多亿数据,那么这个量如果用一张单表存放的话,数据库肯定扛不住。
- **要点2:**但是,归档之后,热数据的表还要保留30的数据,也就是3个亿,那还是很多的,单靠数据库也扛不住。
- **要点3:**因为要同时满足买家和卖家的查询,不可能只基于买家或者卖家去做分表。
- **要点4:**那么,这个问题最终就变成了一个, 如何基于海量数据(3亿)数据走高效查询,并且要支持多个分表键。
- **要点5:**之所以按照买家 ID 先做分表,就是为了避免数据倾斜。
**记忆锚点:**ID+ → OceanBase → 时间等多个联合索引 → 一天一千万条数据 → pingcap → Spanner
易错提醒:
- 需要考虑做分库分表 4、分表键不能直接选择买家或者卖家 因为要同时满足买家和卖家的查询,不可能只基于买家或者卖家去做分表。
- 之所以按照买家 ID 先做分表,就是为了避免数据倾斜。
加分表达:
- 分析一下题干的几个关键信息: 1、一天一千万数据。
- 2、只查最近30天的数据 3、买家和商家都需要查询 通过以上三个信息,我们可以得出以下结论: 1、单表 扛不住 : 1天就1000万数据,一年就30多亿数据,那么这个量如果用一张单表存放的话,数据库肯定扛不住。
- 如果按照卖家 id 分表,那么买家的查询就会跨表,查询很慢。
追问准备:
- 围绕「ID+」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「OceanBase」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「时间等多个联合索引」:底层原理是什么?使用时有哪些边界和常见坑?
- 如果线上出现异常,你会如何定位、验证并规避?
典型回答
分析一下题干的几个关键信息:
1、一天一千万数据。
2、只查最近30天的数据
3、买家和商家都需要查询
通过以上三个信息,我们可以得出以下结论:
1、单表扛不住:
1天就1000万数据,一年就30多亿数据,那么这个量如果用一张单表存放的话,数据库肯定扛不住。
2、可以做数据归档
因为用户只查询最近30天的数据,所以,可以简单的按照时间来划分冷热数据,30天内的数据为热数据,30天以外的数据为冷数据。冷数据和热数据可以做分离,即针对30天以上的数据做归档。
3、归档后单表还是扛不住
但是,归档之后,热数据的表还要保留30的数据,也就是3个亿,那还是很多的,单靠数据库也扛不住。需要考虑做分库分表
4、分表键不能直接选择买家或者卖家
因为要同时满足买家和卖家的查询,不可能只基于买家或者卖家去做分表。如果按照卖家 id 分表,那么买家的查询就会跨表,查询很慢。按照买家 id 分表也是同理。
5、基本不太可能使用缓存提效
这个很好理解,一方面是数据量太大了,另外一方面订单信息可能会频繁修改,数据一致性不太好保障,这里用缓存不合适。
那么,这个问题最终就变成了一个,如何基于海量数据(3亿)数据走高效查询,并且要支持多个分表键。
分布式数据库
首先,我们可以用支持海量数据存储和查询的各种分布式数据库,如TiDB(pingcap)、OceanBase(蚂蚁)、Spanner(google)等。
用了分布式数据库之后,为了提升买家和卖家的查询效率,需要分别创建索引:
plain
CREATE TABLE Orders (
    order_id BIGINT AUTO_INCREMENT PRIMARY KEY,
    buyer_id BIGINT NOT NULL,
    seller_id BIGINT NOT NULL,
    order_date DATETIME NOT NULL,
    amout DECIMAL(10, 2),
    status ENUM('Pending', 'Completed', 'Cancelled', 'Refunded'),
    INDEX idx_buyer_date (buyer_id, order_date),
    INDEX idx_seller_date (seller_id, order_date)
);创建买家ID+时间、卖家 ID+时间等多个联合索引,来提升按照时间查询的效率。
分库分表
除了分布式数据库,还可以用分库分表的方案,在分库分表中我们介绍过,按照买家 ID 分表后,卖家的查询怎么办问题。
也就是说,我们在做了数据归档之后(一般是先分表之后然后再归档,但是不重要,你知道需要归档即可。),针对最近30天的数据,可以按照买家 ID进行分表,这么大的量 ,建议分成64张表,这样平均下来,单张表就大概有1000万 * 30 / 32不到一千万条数据了。这时候按照买家 ID 的查询就很高效了。
之所以按照买家 ID 先做分表,就是为了避免数据倾斜。建表语句如下:
plain
CREATE TABLE orders (
    order_id BIGINT AUTO_INCREMENT PRIMARY KEY,
    buyer_id BIGINT NOT NULL,
    seller_id BIGINT NOT NULL,
    order_date DATETIME NOT NULL,
    amout DECIMAL(10, 2),
    status ENUM('Pending', 'Completed', 'Cancelled', 'Refunded'),
    INDEX idx_user_date (buyer_id, order_date)
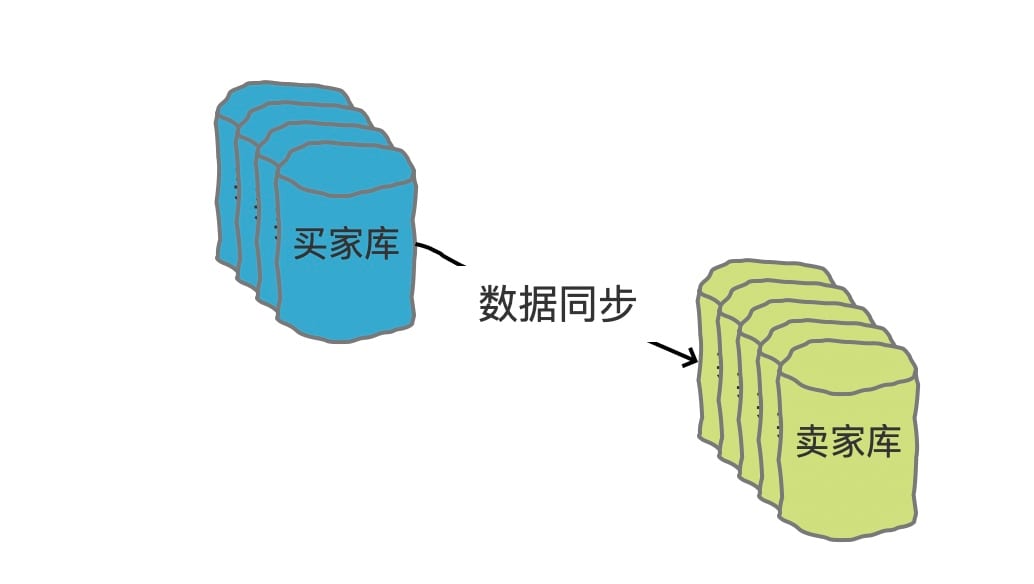
);这样就解决了买家的查询效率问题,那么卖家的查询呢,我们可以采用数据同步的方案,利用空间换时间的方案,将数据冗余一份,再以卖家 ID 做分表:
plain
CREATE TABLE orders_seller (
    order_id BIGINT AUTO_INCREMENT PRIMARY KEY,
    buyer_id BIGINT NOT NULL,
    seller_id BIGINT NOT NULL,
    order_date DATETIME NOT NULL,
    amout DECIMAL(10, 2),
    status ENUM('Pending', 'Completed', 'Cancelled', 'Refunded'),
    INDEX idx_seller_date (seller_id, order_date)
);我们说同步一张卖家维度的表来,但是其实所有的写操作还是要写到买家表的,只不过需要准实时同步的方案同步到卖家表中。也就是说,我们的这个卖家表理论上是没有业务的写操作,只有读操作的。