主题
面试速答(先看这里)
**一句话结论:**XXL-JOB 作为一个定时任务调度工具,他需要确保同一时间内同一任务只会在一个执行器上执行。
60秒标准回答:
XXL-JOB 作为一个定时任务调度工具,他需要确保同一时间内同一任务只会在一个执行器上执行。这个特性对于避免任务的重复执行非常关键,特别是在分布式环境中,多个执行器实例可能同时运行相同的任务
这个特性被XXL-JOB描述为“调度一致性”,并且官方文档也给出了这个问题的答案
“调度中心”通过DB锁保证集群分布式调度的一致性, 一次任务调度只会触发一次执行
**答题顺序:**结论 → 原理/机制 → 关键流程 → 场景与取舍 → 易错点
回答主线:
- **要点1:**这个特性被XXL-JOB描述为“调度一致性”,并且官方文档也给出了这个问题的答案:
- 要点2:“调度中心”通过DB锁保证集群分布式调度的一致性, 一次任务调度只会触发一次执行;
- **要点3:**调度相关的JobScheduleHelper是XXL-JOB中的一个核心组件,负责协调任务的调度逻辑 ,确保任务触发的正确性和唯一性。
- **要点4:**这里面的 select * from xxl_job_lock where lock_name = 'schedule_lock' for update 是关键,这明显是一个基于数据的悲观锁实现的一个加锁过程。
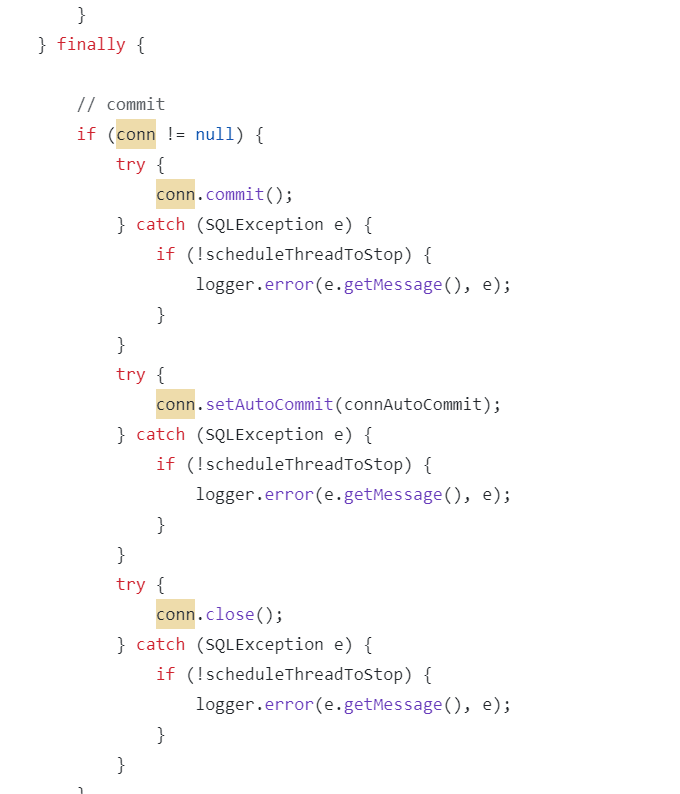
- **要点5:**并且这个锁会随着事务的存在一直存在,这个事务最最终是在方法的finally中实现的:
**记忆锚点:**XXL-JOB → xxl_job_lock → JobScheduleHelper → schedule_lock → lock_name → select
易错提醒:
- 这个特性对于避免任务的重复执行非常关键,特别是在分布式环境中,多个执行器实例可能同时运行相同的任务。
加分表达:
- 调度相关的JobScheduleHelper是XXL-JOB中的一个核心组件,负责协调任务的调度逻辑 ,确保任务触发的正确性和唯一性。
- 通过查看 JobScheduleHelper 的源码,在他的scheduleThread的方法中,我们可以看到以下代码 这里面的 select * from xxl_job_lock where lock_name = 'schedule_lock' for update 是关键,这明显是一个基于数据的悲观锁实现的一个加锁过程。
追问准备:
- 围绕「XXL-JOB」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「xxl_job_lock」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「JobScheduleHelper」:底层原理是什么?使用时有哪些边界和常见坑?
- 如果线上出现异常,你会如何定位、验证并规避?
典型回答
XXL-JOB 作为一个定时任务调度工具,他需要确保同一时间内同一任务只会在一个执行器上执行。这个特性对于避免任务的重复执行非常关键,特别是在分布式环境中,多个执行器实例可能同时运行相同的任务。
这个特性被XXL-JOB描述为“调度一致性”,并且官方文档也给出了这个问题的答案:

“调度中心”通过DB锁保证集群分布式调度的一致性, 一次任务调度只会触发一次执行;
调度中心在XXL-JOB中负责管理所有任务的调度,它知道哪些任务需要执行,以及任务的调度配置(如CRON表达式)。当到达指定的执行时间点,调度中心会选择一个执行器实例来执行任务。
调度相关的JobScheduleHelper是XXL-JOB中的一个核心组件,负责协调任务的调度逻辑,确保任务触发的正确性和唯一性。
通过查看JobScheduleHelper的源码,在他的scheduleThread的方法中,我们可以看到以下代码
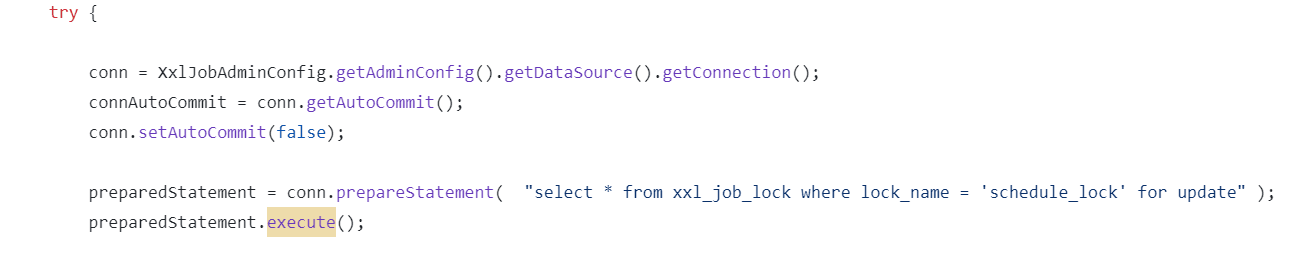
这里面的select * from xxl_job_lock where lock_name = 'schedule_lock' for update是关键,这明显是一个基于数据的悲观锁实现的一个加锁过程。
> xxl_job_lock是XXL-JOB的一张表,是一张任务调度锁表;在使用XXL-JOB的时候需要提前创建好这张表。并且需要提前插入一条记录:INSERT INTO `xxl_job_lock` ( `lock_name`) VALUES ( 'schedule_lock'); > > 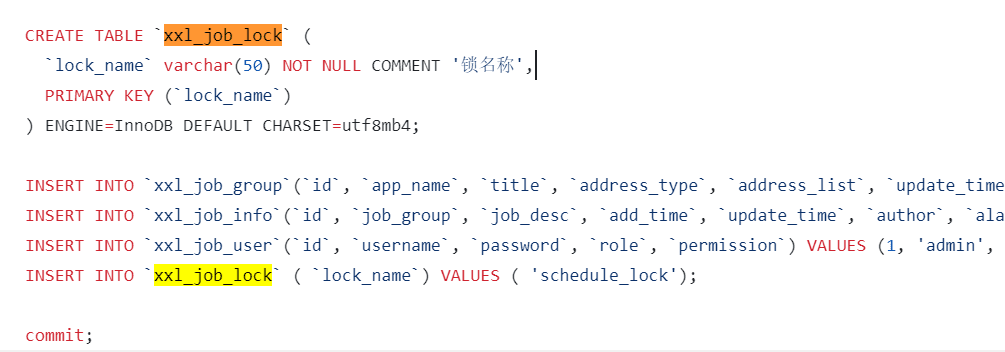 > > 来自 tables_xxl_job.sql
通过select for update的方式添加一个悲观锁,可以确保在同一时刻,只能有一个事务获取到锁。这样获取到锁的线程就可以执行任务的调度了。
并且这个锁会随着事务的存在一直存在,这个事务最最终是在方法的finally中实现的: