
主题
面试速答(先看这里)
**一句话结论:**和InnoDB最大的不同,MyISAM是采用了一种索引和数据分离的存储方式,也就是说,MyISAM中索引文件和数据文件是独立的。
60秒标准回答:
和InnoDB最大的不同,MyISAM是采用了一种索引和数据分离的存储方式,也就是说,MyISAM中索引文件和数据文件是独立的
因为文件独立,所以在MyISAM的索引树中,叶子节点上存储的并不是数据,而是数据所在的地址。所以,MyISAM 存储引擎实际上不支持聚簇索引的概念。在 MyISAM 中,所有索引都是非聚簇索引
也就是说,在MyISAM中,根据索引查询的过程中,必然需要先查到数据所在的地址,然后再查询真正的数据,那么就需要有两次查询的过程。而在InnoDB中,如果基于聚簇索引查询,则不需要回表,因为叶子节点上就已经包含数据的内容了
**答题顺序:**结论 → 原理/机制 → 关键流程 → 场景与取舍 → 易错点
回答主线:
- **要点1:**因为文件独立,所以在MyISAM的索引树中,叶子节点上存储的并不是数据,而是数据所在的地址。
- **要点2:**也就是说,在MyISAM中,根据索引查询的过程中,必然需要先查到数据所在的地址,然后再查询真正的数据,那么就需要有两次查询的过程。
- **要点3:**因为MyISAM是先出的,正式因为存在这个问题,所以后来的InnoDB 引入了聚簇索引的概念提高了数据检索的效率,特别是对于主键检索。
**记忆锚点:**MyISAM → InnoDB → 都是非聚簇索引 → 引入了聚簇索引 → 的索引树 → 根据索引
加分表达:
- 而在InnoDB中,如果基于聚簇索引查询,则不需要回表,因为叶子节点上就已经包含数据的内容了。
追问准备:
- 围绕「MyISAM」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「InnoDB」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「都是非聚簇索引」:底层原理是什么?使用时有哪些边界和常见坑?
- 如果线上出现异常,你会如何定位、验证并规避?
典型回答
和InnoDB最大的不同,MyISAM是采用了一种索引和数据分离的存储方式,也就是说,MyISAM中索引文件和数据文件是独立的。
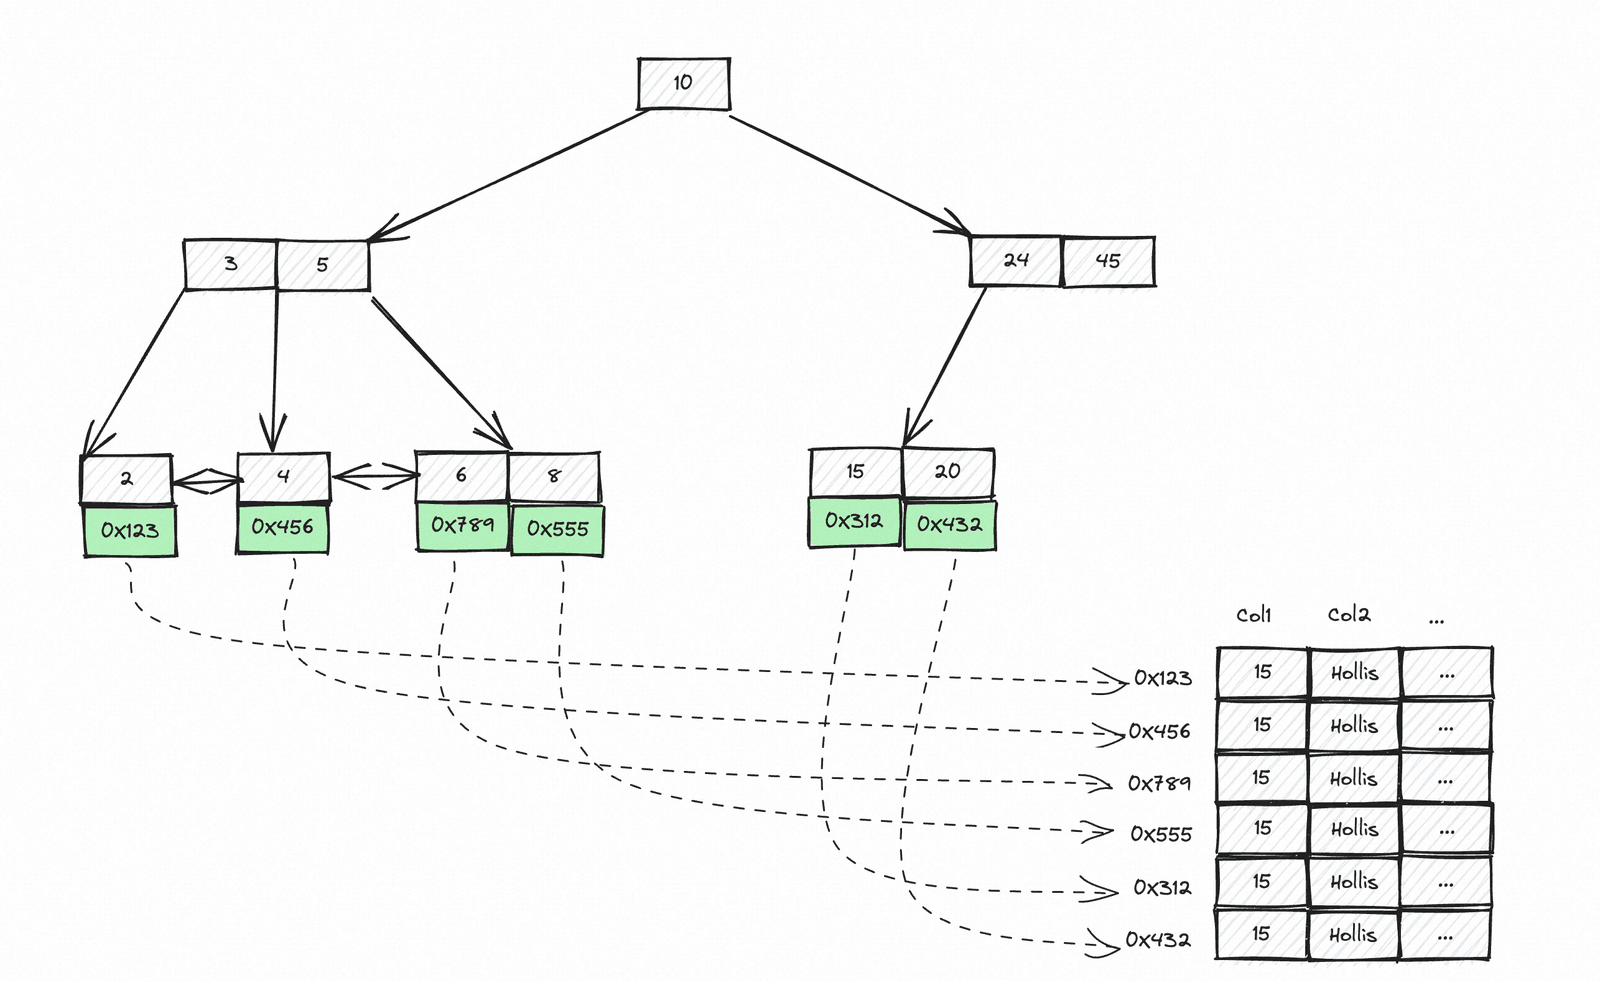
因为文件独立,所以在MyISAM的索引树中,叶子节点上存储的并不是数据,而是数据所在的地址。所以,MyISAM 存储引擎实际上不支持聚簇索引的概念。在 MyISAM 中,所有索引都是非聚簇索引。
也就是说,在MyISAM中,根据索引查询的过程中,必然需要先查到数据所在的地址,然后再查询真正的数据,那么就需要有两次查询的过程。而在InnoDB中,如果基于聚簇索引查询,则不需要回表,因为叶子节点上就已经包含数据的内容了。
因为MyISAM是先出的,正式因为存在这个问题,所以后来的InnoDB 引入了聚簇索引的概念提高了数据检索的效率,特别是对于主键检索。