
主题
面试速答(先看这里)
**一句话结论:**从定义上来说,所谓的树,就是由节点和边组成,且不存在环的一种数据结构。
60秒标准回答:
从定义上来说,所谓的树,就是由节点和边组成,且不存在环的一种数据结构
从实现上来讲,树一般通过链表来实现
从结构上分,树可分为二叉树和多叉树。一般我们在写算法的时候,使用二叉树和字典树比较多
**答题顺序:**结论 → 原理/机制 → 关键流程 → 场景与取舍 → 易错点
回答主线:
- **要点1:**从实现上来讲,树一般通过链表来实现。
- **要点2:**从结构上分,树可分为二叉树和多叉树。
- **要点3:**平衡二叉树(AVL树) :一种自平衡的二叉搜索树,其中任何节点的两个子树的高度差都不超过1。
- **要点4:**B树和B+树 :常用于数据库和文件系统中的多路搜索树,它们通过保持树的平衡和低高度来优化磁盘访问。
- **要点5:**前缀树(Trie树) :一种用于快速检索字符串集合的树形数据结构,节点路径形成的字符串可以快速定位。
**记忆锚点:**红黑树 → 自平衡的二叉搜索树 → 平衡二叉树(AVL树) → 前缀树(Trie树) → 一般用于数据库的索引 → 于快速检索字符串集合
关键取舍:
- (这个是大学数据结构的必修内容,但是面试一般不考) 红黑树和平衡二叉树因为是有序的,所以经常用于二分查找,红黑树相对于平衡二叉树的优点是,不要求树完全平衡,这就会降低数据更新时候的时间复杂度。
易错提醒:
- (这个是大学数据结构的必修内容,但是面试一般不考) 红黑树和平衡二叉树因为是有序的,所以经常用于二分查找,红黑树相对于平衡二叉树的优点是,不要求树完全平衡,这就会降低数据更新时候的时间复杂度。
- (在LeetCode Hard中比较常见) 树的分类如下所示: 注意:上图中的字典树就是Tire树, 平衡二叉树(AVL树) :一种自平衡的二叉搜索树,其中任何节点的两个子树的高度差都不超过1。
加分表达:
- 字典树一般是针对一组字符串进行维护的数据结构,它可以将共同前缀的字符串进行优化,节省存储空间,同时可以快速查询某个字符串是否出现。
- B树和B+树 :常用于数据库和文件系统中的多路搜索树,它们通过保持树的平衡和低高度来优化磁盘访问。
追问准备:
- 围绕「红黑树」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「自平衡的二叉搜索树」:底层原理是什么?使用时有哪些边界和常见坑?
- 围绕「平衡二叉树(AVL树)」:底层原理是什么?使用时有哪些边界和常见坑?
- 如果线上出现异常,你会如何定位、验证并规避?
典型回答
从定义上来说,所谓的树,就是由节点和边组成,且不存在环的一种数据结构。
从实现上来讲,树一般通过链表来实现。
从结构上分,树可分为二叉树和多叉树。一般我们在写算法的时候,使用二叉树和字典树比较多。
除此之外,
- B*树一般用于数据库的索引,特点是由多个子树,高度很低,可以减少磁盘IO;
- 霍夫曼树一般通过哈夫曼编码做数据的无损压缩;(这个是大学数据结构的必修内容,但是面试一般不考)
- 红黑树和平衡二叉树因为是有序的,所以经常用于二分查找,红黑树相对于平衡二叉树的优点是,不要求树完全平衡,这就会降低数据更新时候的时间复杂度。Java中的HashMap就会通过红黑树来进行查找;
- 字典树一般是针对一组字符串进行维护的数据结构,它可以将共同前缀的字符串进行优化,节省存储空间,同时可以快速查询某个字符串是否出现。(在LeetCode Hard中比较常见)
树的分类如下所示:
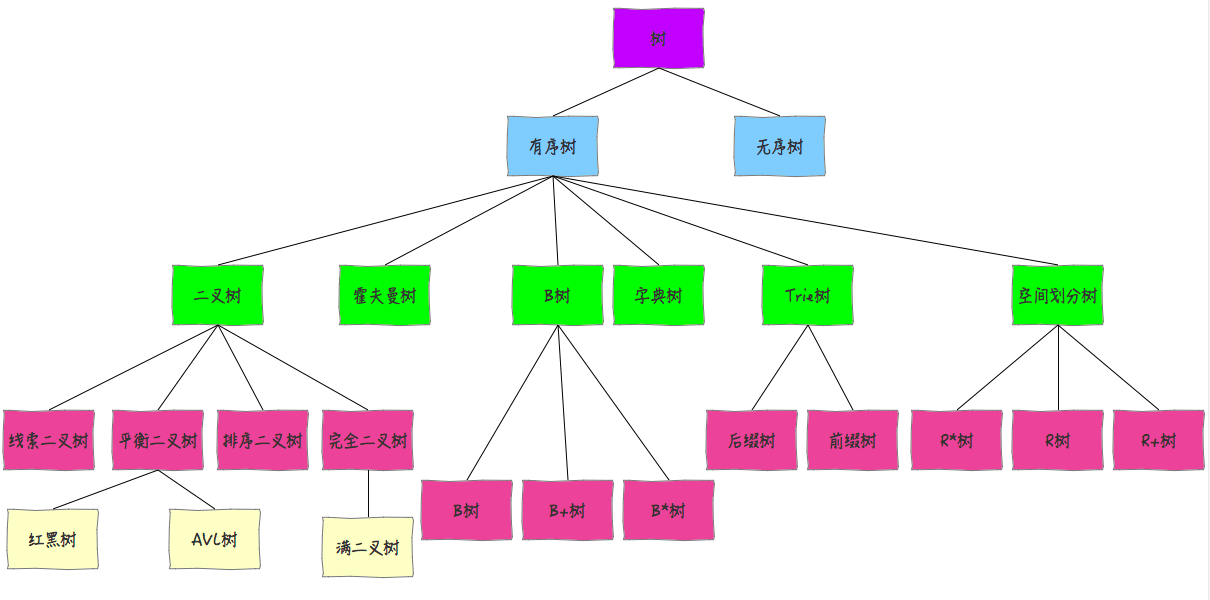
> - 注意:上图中的字典树就是Tire树,
平衡二叉树(AVL树):一种自平衡的二叉搜索树,其中任何节点的两个子树的高度差都不超过1。
红黑树:一种自平衡的二叉搜索树,它通过节点颜色(红色或黑色)和特定的性质来维持大致平衡,以确保操作的时间复杂度保持在对数级别。
B树和B+树:常用于数据库和文件系统中的多路搜索树,它们通过保持树的平衡和低高度来优化磁盘访问。
前缀树(Trie树):一种用于快速检索字符串集合的树形数据结构,节点路径形成的字符串可以快速定位。
知识扩展
二叉查找树的演变和区别?
参考该文章中第二条:为什么是红黑树